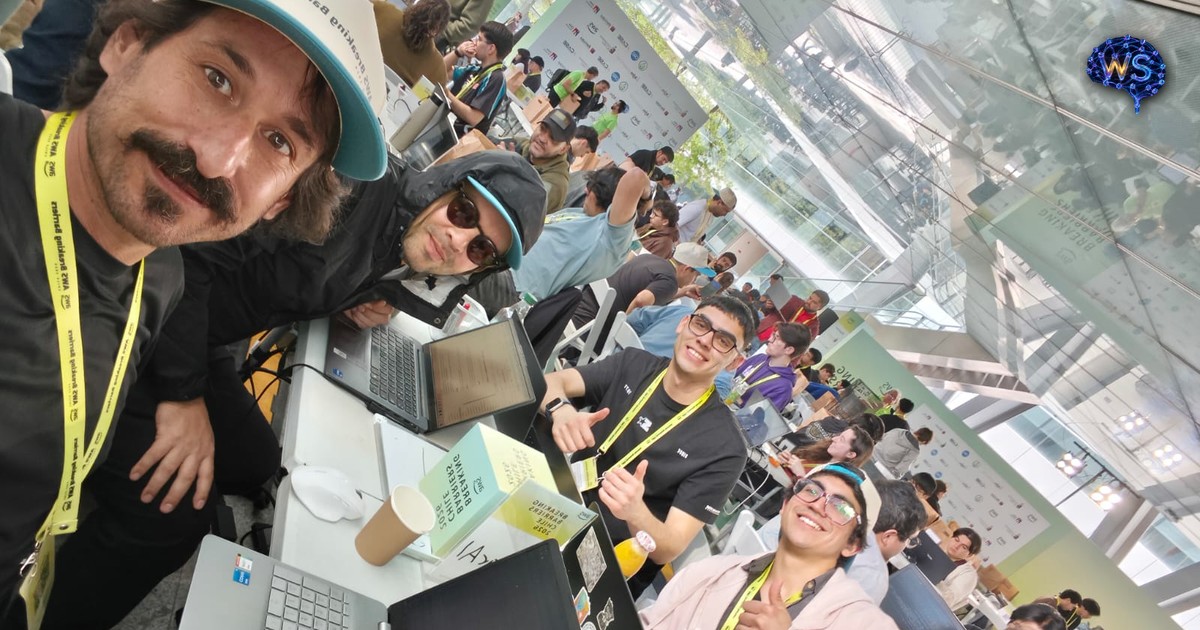
Son las nueve de la mañana del jueves 15 de octubre, en la Facultad de Ciencias Físicas y Matemáticas de la Universidad de Chile. Segundo día del hackatón AWS Breaking Barriers Chile 2026. La sala que ayer estaba llena de caras desconocidas hoy está llena de computadores abiertos, café y una energía distinta. El día 1 fue euforia: elegir el desafío, conocer al equipo, la lección del modelo que no aprendió. El día 2 es otra cosa. El día 2 es donde la máquina tiene que funcionar de verdad.
Y funcionó. Pero no salió como lo imaginábamos. Empezamos la jornada con algo que nadie quiere descubrir un miércoles por la noche: el repositorio roto, la demo rota, y la producción separada del código que la hace correr. Terminamos el día con 21 pull requests integrados, un producto de punta a punta con la educadora en el centro, y una lección que ya intuíamos pero que el día 2 nos grabó a fuego: la IA de este proyecto ya estaba resuelta. Lo que faltaba era el harness.
Esta es la crónica del día 2. La parte fea —el día en que todo se rompió— y la parte hermosa: cómo un cable de integración bien hecho convirtió un prototipo en algo que una profesora real puede usar.
1. El día 2 de un hackatón no premia la idea: premia la integración. El día 1 eliges el problema; el día 2 descubres que el problema real es que las piezas se hablen entre sí.
2. «Despliega directo y no mergees» es la deuda que casi nos cuesta el proyecto. Tres cosas vivas en el servidor no existían en el repositorio. El código que corría no era el código que creíamos tener.
3. La IA ya ganaba; el harness la volvió usable. El motor de evaluación llegaba a 0.96 en su prueba honesta. Lo que tomó todo el día fue que una educadora pudiera ver, corregir y confiar en esa decisión.
4. La lección. Un modelo no es un producto. Un producto es un humano en el loop, un dato en tiempo real, una evidencia que se puede auditar. Eso —otra vez— es el harness.
El aviso de rigor, como en el día 1, porque en este tema es fácil vender humo. Todo lo que vas a leer son hechos verificados en vivo —los pull requests, las métricas de la prueba honesta, los números de la base de datos— salvo donde diga explícitamente que es nuestra lectura. Los conteos de PR y las cifras están al cierre de la jornada, y el benchmark de evaluación sigue siendo interno y preliminar, medido sobre datos sintéticos. Lo que cambia respecto al día 1 es que hoy ya no es una idea: es un sistema desplegado que responde.
1. Por qué el día 2 es el día difícil (y por qué eso es una buena noticia)
Hay un patrón en casi todos los hackatones que se ve bien en las redes: el día 1 es el de las ideas, los discursos, las fotos con el equipo. Y el día 3 es el del pitch, la demo brillante, los aplausos. El día 2 casi nunca se cuenta, y es justo el que decide si vas a tener algo que mostrar.
El día 2 es el día en que dos personas tocan el mismo archivo. En que la base de datos aparece con datos que nadie recuerda haber metido. En que una demo que ayer funcionaba hoy tira un error 500. Es el día del trabajo real: no el de imaginar la solución, sino el de hacer que la solución imaginada no se caiga cuando la tocas.
Y en nuestro caso, eso se materializó en un hallazgo tan concreto que duele contarlo: a las 9 de la mañana, el repositorio que todo el equipo iba a mergear estaba roto. Este es el servicio que recibe los mensajes de WhatsApp de las educadoras y los convierte en evaluaciones. Estaba roto de una forma silenciosa y peligrosa: llamaba a una función que ya no existía en la rama principal. Cualquiera que hubiera clonado el repositorio ese día y desplegado desde él, se habría encontrado con un sistema que no levanta.
En un hackatón se optimiza por velocidad, y eso está bien. Pero hay una velocidad que se paga caro: desplegar directo al servidor sin pasar por el repositorio. Se siente más rápido —un comando y listo—, hasta que la demo corre un código que nadie más tiene, que no está versionado, y que nadie puede reproducir. En ese momento dejas de tener un equipo: tienes islas.
2. El rescate: cómo «main» volvió a ser el código que corre
El día 2 empezó, entonces, con una operación de rescate. Reconstruimos lo que estaba solo en el servidor y nunca en la rama principal. Aparecieron tres cosas que la demo necesitaba y que eran invisibles para cualquiera que leyera el repositorio:
- El sembrador de los cuatro cursos de prueba. Los 111 niños repartidos en cuatro salas con cuatro números de teléfono distintos —la base con la que íbamos a demostrar todo— no existían como código reutilizable. Vivían solo en el servidor.
- Los métodos de ruteo. La lógica que decide a qué sala pertenece un mensaje según quién lo manda. Sin esto, el sistema no sabía de quién era cada observación.
- La cola human-in-the-loop. La famosa «cola por verificar» —el mecanismo por el que una educadora revisa los casos dudosos— no tenía API. Existía, pero nadie la podía usar.
El rescate fueron varios pull requests que devolvieron esas piezas a la rama principal. Y con ellos una lección de higiene que vale más que cualquier línea de código del día: todo lo que corre en producción tiene que poder reconstruirse desde el repositorio. Si no, no es un producto: es una anécdota que funciona en tu máquina.
3. La «rúbrica fantasma»: cuando tu producción deja de ser tu código
Y entonces apareció el hallazgo más elegante —y más aterrador— del día. Lo bautizamos mentalmente la rúbrica fantasma, y es un clásico de la ingeniería que casi ningún hackatón admite en voz alta.
Resulta que el servidor y la rama principal habían divergido. No en una dirección: en las dos. El repositorio tenía cosas que el servidor no tenía (un fix de seguridad nunca desplegado). Y el servidor tenía cosas que el repositorio no tenía (la rúbrica, el motor de evaluación realineado a los criterios que la institución nos había entregado).
El problema es este: si desplegabas desde el repositorio —lo que deberías hacer siempre— borrabas la rúbrica. Es decir, el sistema seguía funcionando, pero dejaba de evaluar según los criterios de Fundación Integra. Seguía respondiendo, seguía luciendo bien... y estaba evaluando con la regla equivocada.
La solución no fue romántica: fue un deploy quirúrgico con red de seguridad. Antes de tocar nada, copia de respaldo del archivo vivo. Luego, en lugar de reemplazar todo el backend por el del repositorio, se inyectó solo la pieza que faltaba —la cola human-in-the-loop—, se verificó que el archivo compilara, y recién ahí se reinició el servicio. Después vinieron los pull requests de rescate que sincronizaron de verdad la rúbrica a la rama principal. Al final del día, por primera vez, el repositorio y la producción eran la misma cosa.
Suena a trabajo de mantenimiento aburrido. Pero es exactamente lo que un prototipo necesita para volverse producto. En un hackatón, esto es la parte que no sale en la foto y que decide todo lo demás.
4. El harness se vuelve producto: la educadora entra al loop
Con el terreno saneado, llegó lo que de verdad cambió el día: pasamos de un sistema que decide a un sistema con el que una persona trabaja. Y esa diferencia —decidir solo versus trabajar con alguien— es toda la diferencia entre una demo y una herramienta.
Recordemos el problema. Una educadora de párvulos manda por WhatsApp una observación de un niño: un texto («hoy Martina se vistió sola»), una foto, un audio, un video. El sistema la entiende, la clasifica en un nivel de desarrollo, y la guarda ordenada. El motor ya evaluaba bien. Pero un producto real no es un motor: es un motor con una profesora que puede confiar en él o corregirlo. Eso fue el día 2.
Lo que se construyó (y por qué cada pieza importa)
| Pieza del harness | Qué resuelve |
|---|---|
| La educadora verifica | Los casos con baja confianza van a una cola de revisión. La profesora puede aprobar, editar o rechazar cada uno desde el panel. El sistema deja de ser una caja negra y se vuelve un asistente. |
| Editar cualquier nivel | Incluso los casos que el sistema resolvió solo y con alta confianza son corregibles. Porque la última palabra sobre el desarrollo de un niño la tiene un adulto, no un modelo. |
| Cola en vivo | Antes, la cola se llenaba solo a medianoche (en la corrida diaria). Ahora, un mensaje dudoso entra a la cola al instante. La profesora lo ve en segundos, no al día siguiente. |
| Tiempo real | El panel se actualiza solo cuando llega una observación nueva, cuando entra un caso a verificar o cuando alguien resuelve uno. Sin recargar. El estado del jardín, vivo. |
| Huella de origen | Cada evaluación guarda si la decidió el sistema o una persona. Trazabilidad total: siempre sabes quién puso qué nivel y por qué. |
Fíjate en el patrón, porque es el mismo del día 1 y ahora se ve todavía más claro. Cuando el sistema está seguro, decide solo y la educadora solo confirma. Cuando está dudoso, no adivina: se lo pasa a una persona. El resultado es un flujo que no es «IA que reemplaza a la tía», sino «IA que le devuelve cuatro horas a la tía y le deja el juicio final a ella».
El día 1 probamos que el gate por margen —derivar los casos dudosos a un humano— es la mejor señal de confianza que existe. El día 2 lo convertimos en interfaz. La tesis dejó de ser un argumento técnico y se volvió una pantalla: la profesora, con botones, decidiendo sobre la IA. Eso es el harness hecho producto.
5. La evidencia no se declara: se muestra
Hay una segunda mitad del día 2 que no es de interfaz sino de honestidad de datos. Y empieza con una prueba que nos obligó a bajar nuestros propios números.
El modelo de decisión (Laya) tenía un número oficial muy bonito: 0,9865 de acierto. Pero al mirarlo con lupa descubrimos que su evaluación se solapaba con su entrenamiento: medía en parte lo que ya había visto. Repetimos la prueba sobre un conjunto limpio —135 casos sin contaminar— y el número honesto fue 0,963. Sigue siendo excelente. Pero es distinto, y esa diferencia es la que separa un claim de un dato.
| Modelo (sobre el held-out limpio) | Acierto exacto | Acierto ±1 nivel |
|---|---|---|
| Laya base (sin ajustar) | 0.119 | 0.296 |
| Laya ajustado (v2) | 0.178 | 0.474 |
| Laya rediseñado (v3) | 0.963 | 0.985 |
Y aquí va la advertencia que hace honesto el número, porque es más incómoda que el número mismo: el conjunto de prueba reutiliza observaciones que el modelo ya había visto. Mide que aprendió el catálogo y que sabe combinarlo —no que vaya a generalizar a un jardín real. Por eso usamos 0,963, no 0,9865, y por eso el dato se presenta como interno y preliminar. Un sistema que cuida a los niños de Chile no se puede permitir un número inflado.
A esa honestidad numérica se sumaron tres verificaciones más, todas hechas en vivo ese mismo día:
- La evidencia, en todas partes. Antes, casi ninguna observación mostraba por qué el sistema había elegido ese nivel. Ahora cada observación va acompañada de las manifestaciones observables —las conductas concretas del catálogo— que respaldan la decisión. Pasamos de 3 observaciones con evidencia a más de 2.300. Es exactamente lo que el desafío pedía: sugerir un nivel con la evidencia que lo respalda.
- Dos niños en un mensaje. Si la tía escribe «Emilia y Cristóbal jugaron juntos», el sistema ahora registra la observación en ambos, con el nombre de cada uno. Antes solo guardaba al primero. Parece un detalle; es la diferencia entre un juguete y una herramienta.
- Video, de verdad. Probamos el flujo completo con un video real de un bebé: el sistema lo describe («levanta la cabeza y la sostiene unos segundos…»), identifica al niño, extrae las manifestaciones, lo manda a verificar… y luego borra la grabación. La privacidad de un niño no es un checkbox: es un paso del pipeline.
Durante el día encontramos un bug pequeño y delicioso: el sistema guardaba texto como formato de captura para los videos y las fotos. El sistema funcionaba, pero mentía sobre lo que había recibido. Lo arreglamos —ahora registra «video», «imagen», «audio»— porque un dato mal etiquetado es una decisión mal tomada esperando su turno.
6. Veintiún pull requests: el día en que el prototipo se volvió sistema
Vale la pena poner el acumulado sobre la mesa, porque es la medida real de lo que pasó en un solo día de trabajo (todo mergeado y desplegado entre las 9:00 y las 21:00):
| Frente | Qué se integró |
|---|---|
| Estabilidad | Rescate de la rama principal, sincronización producción ↔ repositorio, fix del drift de un módulo entero que hacía caer el endpoint de procesamiento. |
| Producto | Paneles de educadora y directora, la cola de verificación con aprobar/editar/rechazar, edición de niveles, datos en vivo por streaming. |
| Evaluación | Motor alineado a la rúbrica institucional, alerta de rezago relativo al grupo-curso (no al promedio nacional), vista comparativa por jardín. |
| Datos | Evidencia (manifestaciones) en todas las observaciones, ingesta multi-niño, formato real de captura, sembrado de los cuatro cursos de prueba. |
En total: 21 pull requests integrados, cero ramas abiertas al cierre, y un repositorio que por fin cuenta la misma historia que el servidor. Y una cifra que resume el salto de escala: la base pasó a tener más de 600 niños y más de 5.000 observaciones repartidas en los cuatro cursos de prueba, con homónimos a propósito para forzar al sistema a distinguir personas.
Hay un momento, en un hackatón, en que dejas de construir una demo y empiezas a construir un producto. No lo marca una línea de código: lo marcas cuando puedes perder el servidor, reconstruirlo desde el repositorio, y que todo vuelva a funcionar. Ese umbral lo cruzamos el día 2.
7. Por qué esto importa (y no es una charla de ingenieros)
Podríamos cerrar con una moraleja sobre integración de software. Pero sería dejar afuera lo que de verdad está en juego.
Del otro lado de todo este trabajo de plomería hay una educadora de párvulos. Hay 111 niños en cuatro salas de prueba que hoy existen solo en un ambiente sintético —pero que representan a los cientos de miles que hay en los jardines de Fundación Integra. Y hay una pregunta que el día 2 nos obligó a mirar de frente: ¿estamos construyendo algo que reemplaza el juicio de una persona, o algo que lo fortalece?
La respuesta, después de este día, es la segunda —y no por una postura ideológica, sino por una decisión de diseño. El sistema no decide solo cuando no está seguro: le pasa la pelota a la tía. No esconde su razonamiento: muestra la evidencia. No se lleva los datos de los niños: borra los videos después de procesarlos. Cada una de esas decisiones parece técnica; todas son éticas.
Eso es lo que aprendimos el día 2, y es la misma lección del día 1 llevada un paso más lejos. En el día 1, el modelo de moda no nos salvó: nos hundió. En el día 2, el modelo de evaluación ya ganaba —y no fue suficiente. Lo que convirtió un motor que acierta en un sistema en el que una profesora confía fue todo lo demás: la cola, el tiempo real, la evidencia, la trazabilidad, el botón de editar. El harness. Otra vez el harness. Siempre el harness.
Mañana es el último día: congelar el desarrollo a media mañana, la pre-evaluación técnica, y el pitch. Pero el día 2 ya nos dejó lo importante. No un truco, no un modelo: un producto que respira, con una profesora dentro del loop y un repositorio que dice la verdad.
Nos vemos en el día 3.
El modelo no es el producto: el sistema que lo vuelve confiable, sí.
Si estás llevando IA a un proceso donde la decisión importa —y no puedes permitirte adivinar—, hablemos. Diseñamos el harness: humano en el loop, evidencia auditable y datos que no salen de tu infraestructura.
Hablemos 30 minutos →