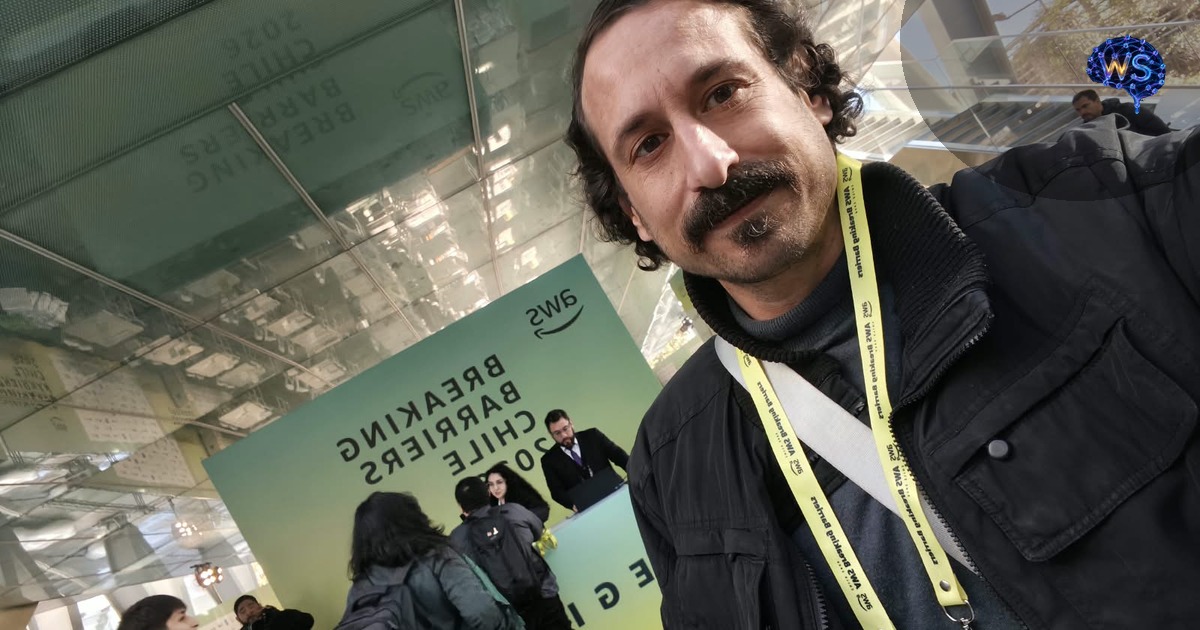
Son las once de la mañana del miércoles 14 de octubre, en el hall de la Facultad de Ciencias Físicas y Matemáticas de la Universidad de Chile. Hay credenciales amarillas por todos lados, un stand con el logo de AWS, y una sala llena de gente que todavía no se conoce. Sobre la mesa, el programa del día: acreditación, inauguración, y a las 11:00 el momento que define todo — la presentación de los desafíos y la conformación de los equipos.
Nosotros llegamos con una idea en la cabeza. Y nos fuimos del día 1 con otra completamente distinta. No porque hayamos fallado en el plan, sino porque el primer día de un hackatón te enseña algo que ningún deck te va a decir: que el modelo de moda no resuelve tu problema, y que el equipo que te toca importa más que la herramienta que traes.
Esta es la crónica de ese primer día. La parte humana —cómo nos armaron el equipo— y la parte incómoda: la hora en que intentamos entrenar el modelo de moda, lo vimos colapsar, y terminamos construyendo algo mejor.
1. El primer día no se trata de código: se trata de con quién te toca. Nos juntaron a dos estudiantes universitarios —uno de astronomía, uno de ciencias de la computación— con dos personas del mundo privado. Cuatro formas distintas de mirar el mismo problema.
2. La trampa del "modelo de moda". Llegamos con la intención de afinar (fine-tune) Laya, el modelo de decisión open source del que hablamos hace semanas. Parecía el camino obvio.
3. El experimento nos contradijo. El modelo afinado empeoró. El ensamble híbrido —modelo chico + reglas + margen de confianza— no solo lo superó: lo aplastó.
4. La lección. El modelo no es el foso. La decisión lo es. Y en un proyecto que impacta el desarrollo de los niños de Chile, esa diferencia deja de ser técnica y se vuelve ética.
El aviso de rigor, antes de seguir, porque en este tema es fácil vender humo. Los números que vas a ver en esta crónica son nuestros, medidos sobre un set de 300 notas sintéticas —realistas, pero sintéticas—, y son preliminares. No son un paper, ni una afirmación de estado del arte. Son lo que un equipo midió en su primera tarde de hackatón, con honestidad radical y datos sobre la mesa. Y precisamente por eso creemos que valen la pena: muestran el proceso, no solo el resultado.
1. El desafío que elegimos: cerrar una brecha de cuatro horas semanales
Cuando se presentaron los desafíos reales —los de las instituciones que ese día estaban en la sala— había ocho frentes: gobierno digital, hospitales, tornados, flota eléctrica y, entre ellos, tres de Fundación Integra, la red de jardines infantiles más grande de Chile.
El que nos atrapó fue el Desafío E-1, y su enunciado es casi brutal en su simplicidad:
Cuatro horas por semana, por educadora. Multiplícalo por miles de educadoras y por cada semana del año. Ahí ya no es un problema de productividad: es tiempo de infancia que se está yendo en papeleo. Y como tesis, era perfecta para nosotros: no era un chatbot que "escribe bonito" sobre un niño. Era un sistema que tiene que decidir —clasificar una observación en un nivel de desarrollo, de forma auditable y confiable— porque de esa decisión depende la trayectoria de aprendizaje de un niño real.
La educadora manda un mensaje por WhatsApp: una nota ("hoy Martina se vistió sola"), una foto, un audio, un video. El sistema lo entiende, lo evalúa, lo guarda ordenado por jardín › educadora › niño › observación y responde por el mismo canal. El KPI es concreto y medible: bajar de 4 horas semanales a ~0, devolviéndole a la tía el tiempo para lo que de verdad importa.
2. La dinámica: cómo nos armaron el equipo (y por qué fue lo mejor del día)
A las 11:00, los organizadores explicaron la mecánica. No elegías a tu equipo: te emparejaban. La idea es deliberada — si te juntas con gente con la que ya trabajas, piensas como ya piensas. El hackatón quería lo contrario: forzar miradas distintas sobre el mismo problema.
Y nos tocó un grupo que, mirándolo en retrospectiva, fue el verdadero regalo del día. Éramos cuatro del equipo de trabajo, y veníamos de tres mundos:
| Perfil | De dónde viene | Qué aporta al problema |
|---|---|---|
| Estudiante de Astronomía | Mundo académico-científico | Rigor en los datos, método, pensar en distribuciones y no en certezas binarias |
| Estudiante de Ciencias de la Computación | Mundo académico-técnico | Ingeniería, arquitectura de software, velocidad de implementación |
| Nosotros — mundo privado | Empresa / producto | Criterio de negocio, de usuario real, y de "esto cómo se vende y se sostiene" |
La tentación, en un hackatón, es que gane el más rápido tecleando. Pero lo que pasó fue otra cosa: cada perfil evitó que los otros se equivocaran. Los estudiantes nos bajaban los pies a tierra cuando nos íbamos en voladas de arquitectura; nosotros los bajábamos a ellos cuando se enamoraban de una solución elegante pero que ninguna educadora iba a usar. El rigor científico convertía nuestras corazonadas en hipótesis medibles; el criterio de negocio convertía sus experimentos en producto.
Un equipo multidisciplinario no es más lento: es más difícil de coordinar y más difícil de equivocar en grande. La diversidad de perfiles no te da mejores líneas de código —te da mejores preguntas. Y en 72 horas, las buenas preguntas valen más que las buenas respuestas.
3. La trampa del "modelo de moda": quisimos entrenar Laya
Con el equipo y el problema definidos, entramos a la parte técnica con una idea que traíamos cocinada desde hace semanas. Y aquí hay que ser honestos: la decisión inicial fue la de casi todo el mundo. Quisimos entrenar el modelo de moda.
El modelo era Laya: un "decision model" open source (licencia Apache 2.0, unos 421 millones de parámetros, ~1 GB en memoria) que no chatea —decide. Recibe un input y devuelve una decisión tipada y calibrada (una distribución de probabilidad sobre opciones, en decenas de milisegundos). Es exactamente el tipo de pieza que habíamos estado analizando: la idea de que el LLM escribe y el modelo de decisión decide.
Para nuestro problema, encajaba de forma casi poética. La tarea es clasificar una observación en un nivel del 1 al 9: un espacio finito, enumerable, auditable. No queríamos que un LLM "opinara" en texto libre el desarrollo de un niño: queríamos una decisión tipada con confianza calibrada. Y la fruta parecía al alcance de la mano: si Laya venía con un rendimiento base y nosotros teníamos datos reales de Integra, afinar el modelo con esos datos debía dar un salto.
Sumaba otro argumento que nos importaba de verdad: Laya corre local, on-premise. En un proyecto que trata datos de niños —y con la Ley 21.719 encima—, que el modelo no mande nada a la nube es una ventaja de soberanía, no un detalle técnico. Teníamos modelo, teníamos datos, teníamos motivación. El camino parecía obvio.
Y ahí, en la primera tarde, nos dimos de frente con la pared.
4. El experimento que nos contradijo
Montamos un benchmark con 300 notas sintéticas realistas para medir, de forma honesta, cómo clasificaba cada motor. El resultado del modelo de moda, en su versión base, fue este:
| Motor | Acierto exacto | Acierto ±1 nivel |
|---|---|---|
| Laya base (sin ajustar) | 0.507 | 0.857 |
No era malo. Un 50% de acierto exacto en una escala de 9 niveles, con un 85% de acierto dentro de un nivel de distancia, es una base razonable. Y ahí fue exactamente donde cayó nuestra intuición: "si afinamos el modelo con nuestros datos, esto sube".
Lo afinamos. Y el resultado fue el golpe:
| Motor | Acierto exacto | Acierto ±1 nivel |
|---|---|---|
| Laya base (sin ajustar) | 0.507 | 0.857 |
| Laya afinado (v1) | 0.137 | 0.480 |
El modelo afinado colapsó: pasó de 0.507 a 0.137 de acierto exacto. Habíamos tomado un modelo razonable y lo habíamos vuelto malo. La causa no era misteriosa —el ajuste con muy pocos datos y criterios mal especificados lo empujó a sobreajustarse y a "creer" que todos los niveles eran uno solo—, pero el mensaje era inapelable: nuestra hipótesis central acababa de fracasar en 20 minutos.
Intentamos una segunda versión, con criterios descriptivos y estrategias de congelado del encoder. Mejoró marginalmente (de un 13,5% a un 19,6% en la métrica interna), pero seguía siendo débil. Y con el reloj del hackatón corriendo, había que tomar una decisión incómoda: o seguíamos peleando con el modelo de moda, o aceptábamos que el problema pedía otra arquitectura.
La trampa no fue técnica: fue emocional. Nos habíamos enamorado del modelo. Laya era la pieza elegante, la que habíamos estudiado, la que "debía" funcionar. El fine-tuning fallido fue, en realidad, un favor: nos obligó a dejar de resolver el problema de cómo queríamos vernos y a resolver el problema de lo que de verdad había que resolver.
5. El pivote: el ensamble híbrido que sí ganó
El pivote fue simple de decir y trabajoso de hacer: dejar de pedirle todo a un modelo. En vez de buscar la pieza mágica, combinamos señales distintas, cada una fuerte donde la otra era débil:
- Un matcher híbrido que, usando embeddings de texto (Amazon Titan) más un léxico propio, identifica qué manifestaciones observables del catálogo aparecen en la nota. Esto es evidencia auditable: sabemos exactamente por qué el sistema dijo lo que dijo.
- Un prior etario que aporta el contexto esperable para la edad del niño.
- Y el propio Laya, ya no como protagonista, sino como un voto más dentro de un ensamble.
El resultado, medido sobre el mismo set de 300 notas, fue este:
| Motor | Acierto exacto | Acierto ±1 nivel |
|---|---|---|
| Laya base | 0.507 | 0.857 |
| Laya afinado | 0.137 | 0.480 |
| Matcher híbrido (Titan + léxico + prior) | 0.663 | 0.690 |
| ENSEMBLE (0.6 · híbrido ⊕ 0.4 · Laya) | 0.940 | 0.973 |
| ENSEMBLE + gate (margen ≥ 0.15) | 0.98 en 83% aceptado | 17% se escala a revisión humana |
El ensamble llegó a 0.940 de acierto exacto: prácticamente el doble que el mejor motor individual (0.663 del híbrido) y siete veces mejor que el modelo afinado que habíamos creído la apuesta ganadora. Y la guinda no fue solo el acierto, sino cómo lo usamos.
Cada predicción viene con un margen: la diferencia entre la mejor opción y la segunda. Cuando ese margen es amplio, el sistema decide solo. Cuando es estrecho (menor a 0.15), no adivina: se lo escala a la educadora. El resultado es 0.98 de acierto en el 83% de los casos que resuelve solo, y el 17% restante va a revisión humana en vez de a un error silencioso.
La mejor señal no era el modelo. El gate de calidad no lo dispara la verificación de Laya: lo dispara el margen del ensamble. Es una señal más simple, más barata y más confiable que la que el modelo de moda ofrecía.
Y eso es exactamente la tesis del harness que venimos sosteniendo: el valor no está en el modelo que eliges, sino en la arquitectura que pones alrededor —contratos, evidencia, márgenes, gates, human-in-the-loop—. Mismo problema, distinta arquitectura, resultado abismalmente distinto.
6. La lección que un hackatón te da en 72 horas (y una empresa, en meses)
Hay una razón por la que este pivote importa más allá de la anécdota. Es la misma lección que venimos escribiendo desde hace varios artículos, pero esta vez la vivimos en carne propia en una sola tarde.
La industria te empuja a creer que el resultado depende del modelo: que si usas el más grande, el más nuevo, el que topea el leaderboard, tu producto va a funcionar. Y nosotros acabamos de ver lo contrario con nuestras propias manos. El modelo fuerte no nos salvó: nos hundió cuando lo empujamos por el camino equivocado. Lo que nos salvó fue la arquitectura: un matcher auditable, un prior, un ensamble, un gate por margen, y un humano esperando al final del pipeline para los casos difíciles.
El modelo, para el 95% de los problemas reales, es commodity: hay decenas, todos buenos, todos a puntos de distancia. Lo que no es commodity es la decisión bien puesta: qué señal pesa cuánto, cuándo el sistema se atreve a decidir solo, cuándo se calla y pasa la pelota, y cómo se audita. Eso no se compra como una suscripción: se diseña.
7. Por qué esto importa (y no es una discusión de ingenieros)
Podríamos cerrar acá, con una moraleja sobre arquitectura. Pero sería dejar fuera lo que de verdad nos tiene metidos en esto desde las 9 de la mañana.
Del otro lado del sistema hay una educadora de párvulos con 25 niños en la sala y cuatro horas menos por semana para mirar a cada uno. Hay una fundación que forma a los más pequeños de Chile en la etapa donde todo —la motricidad, el lenguaje, la confianza— se juega por primera vez. Y hay niños cuyo desarrollo, hoy, depende de que un adulto exhausto encuentre el tiempo de registrar lo que hicieron.
Cuando afinábamos el modelo y fallábamos, era fácil olvidarlo: se volvía un juego de números. Pero el pivote al ensamble con human-in-the-loop no fue solo una mejora técnica: fue una decisión de diseño coherente con el impacto. Un sistema que clasifica el desarrollo de un niño no puede permitirse adivinar. Tiene que saber cuándo sabe, y sobre todo, saber cuándo no sabe y preguntar. Eso es lo que hace el gate por margen: garantiza que la decisión final sobre un niño siempre tenga un humano cerca.
Ese es el verdadero entusiasmo que nos dejó el día 1: no haber encontrado un truco, sino haber construido algo que usa la mejor tecnología disponible sin abdicar del juicio humano donde más se necesita. Y hacerlo, además, con tecnología abierta y soberana —Laya corre local, los datos de los niños no salen de ninguna nube ajena—, porque la confianza de una familia no se delega a un proveedor extranjero.
Mañana es desarrollo puro. Pasado, el cierre y el pitch. Pero el día 1 ya nos dejó lo importante: un equipo que piensa distinto, un problema que importa de verdad, y la lección de que el modelo no es el producto —lo es la decisión que construyes a su alrededor.
Nos vemos en el día 2.
El valor no está en el modelo: está en el problema resuelto bien.
Si estás integrando IA en un proceso real —y te están vendiendo "el modelo" como si fuera la solución—, hablemos. Construimos harness, no humo.
Hablemos 30 minutos →